差不多同一时间,Cognition 和 Anthropic 都推出了叫 dynamic workflows 的东西。
名字一样,核心想法也一样。底下却是两个很不一样的产品。
我把两边都用了一阵。下面是我作为一个做产品的人怎么读它们:它们共同的地方、分开的地方,以及如果你自己在设计 multi-agent 系统,这意味着什么。哪些来自厂商自己的文档,哪些只是我的理解,我会分开说。
共同的骨架
在最上层,两者的做法一样。模型写一段程序来编排工作。程序把任务派给子 agent,收回它们的结果,最后给你一个总结。
按 @ClaudeDevs 10 月 9 日的公告,Claude Managed Agents 里的 lead agent 会写一份计划,分阶段执行,最后汇总。Devin 走的是另一条路:它写一段 Python 脚本把编排固定下来,之后每次都按同一份脚本运行。
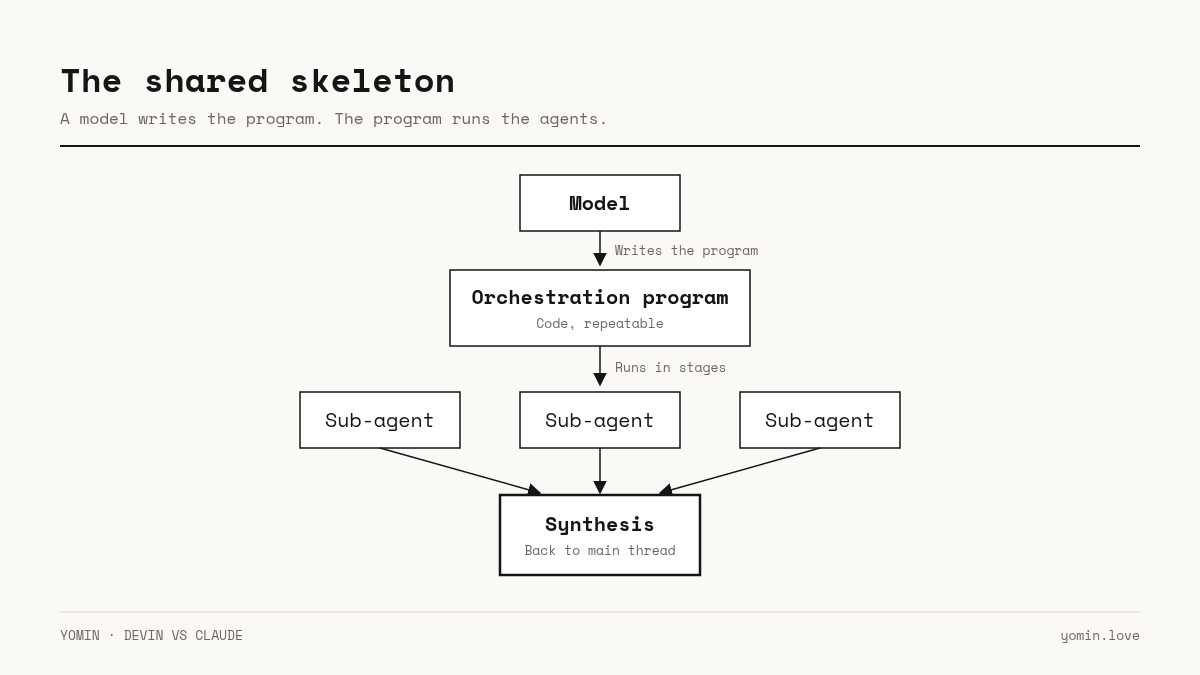
为什么两边都走到了这里?我的猜测是:让一个模型决定每一步的循环,任务一大就变得又贵又难调试。如果计划本身是程序,循环、扇出和重试就是现成的。模型做它擅长的事:决定工作的形状。运行时做它擅长的事:把工作执行完。
七处不同
骨架相同,建在骨架上的选择并不相同。
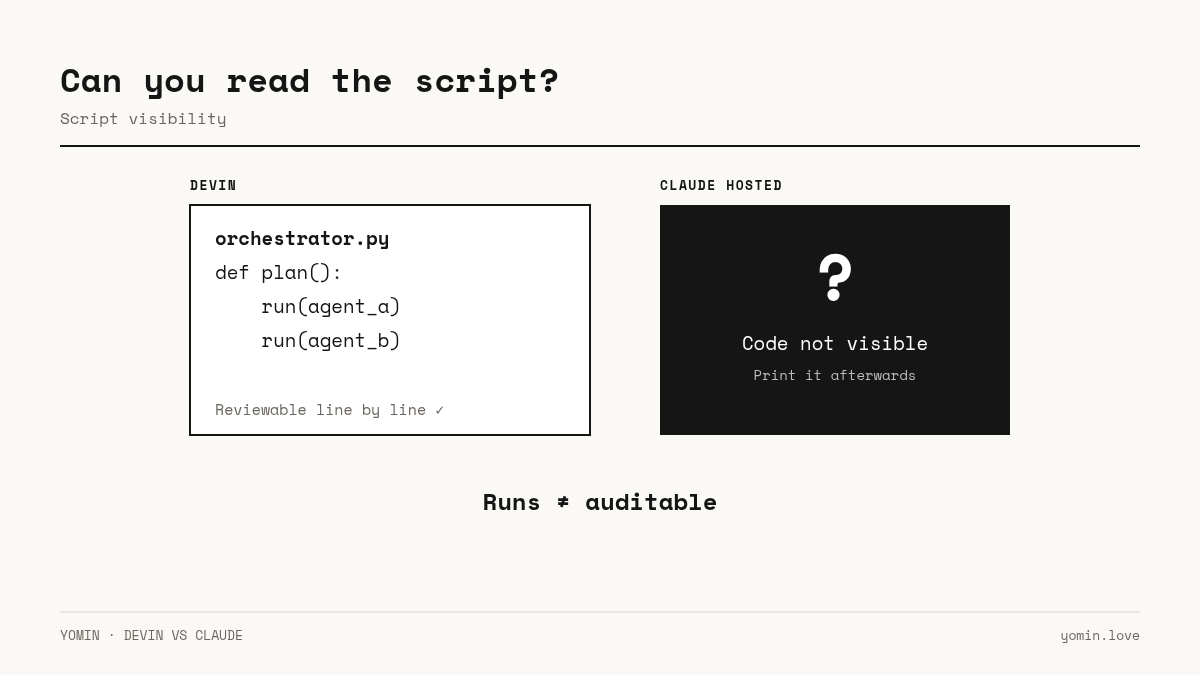
- 脚本可见性。Devin 给你一份能读的 Python 脚本。Managed Agents 里你看不到脚本。按文档,你可以让 agent 事后把它打印出来。
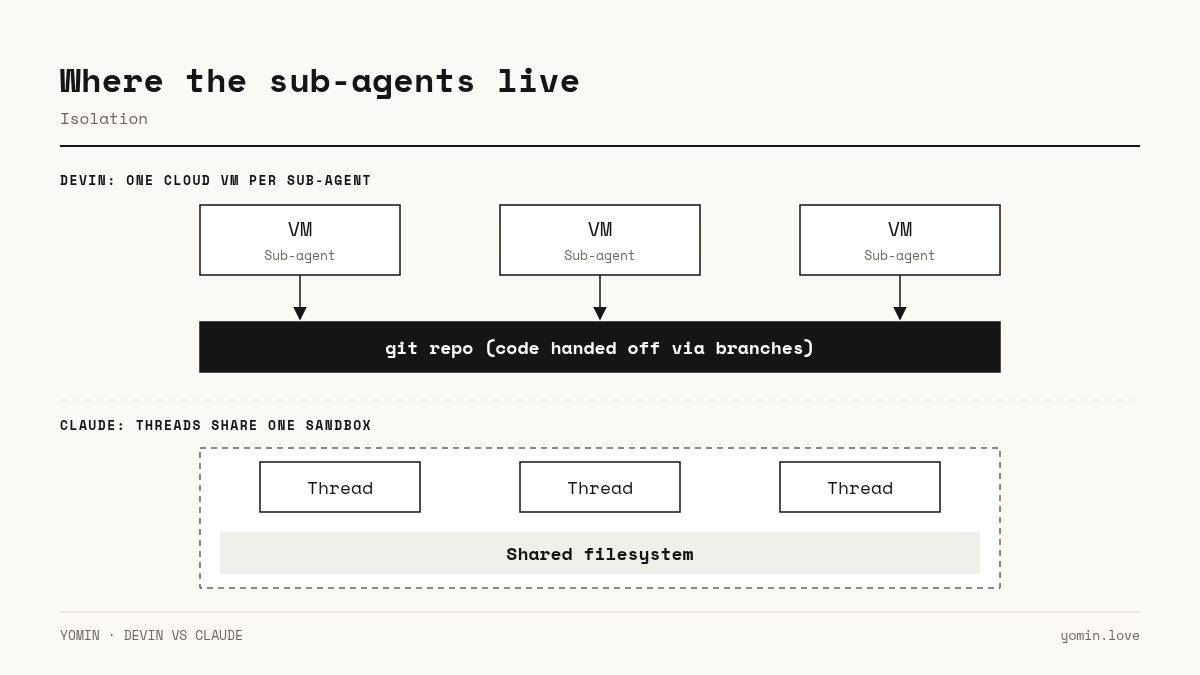
- 隔离。Devin 给每个子 agent 一台独立的云 VM,工作通过 git 分支在它们之间流转。Managed Agents 让所有子 agent 共用一个沙箱。
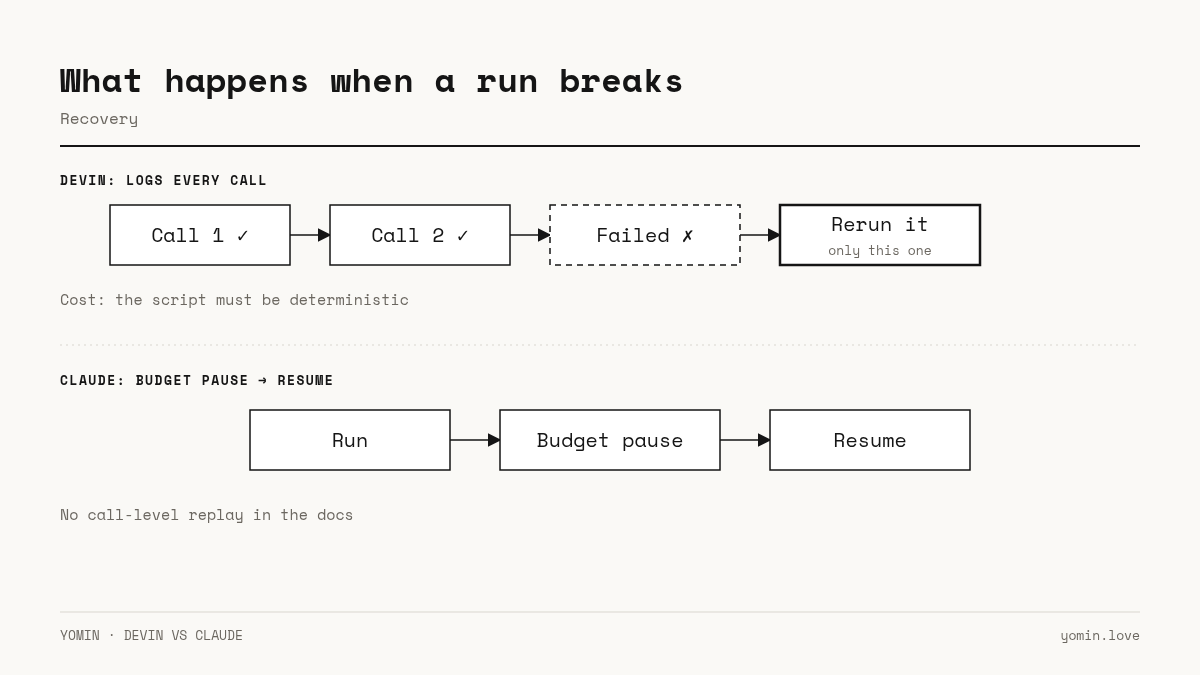
- 恢复。Devin 的运行被打断后,会根据已记录的内容只重跑没完成的部分。Managed Agents 在预算用完时可以暂停,之后再继续,但没有确定性重放。
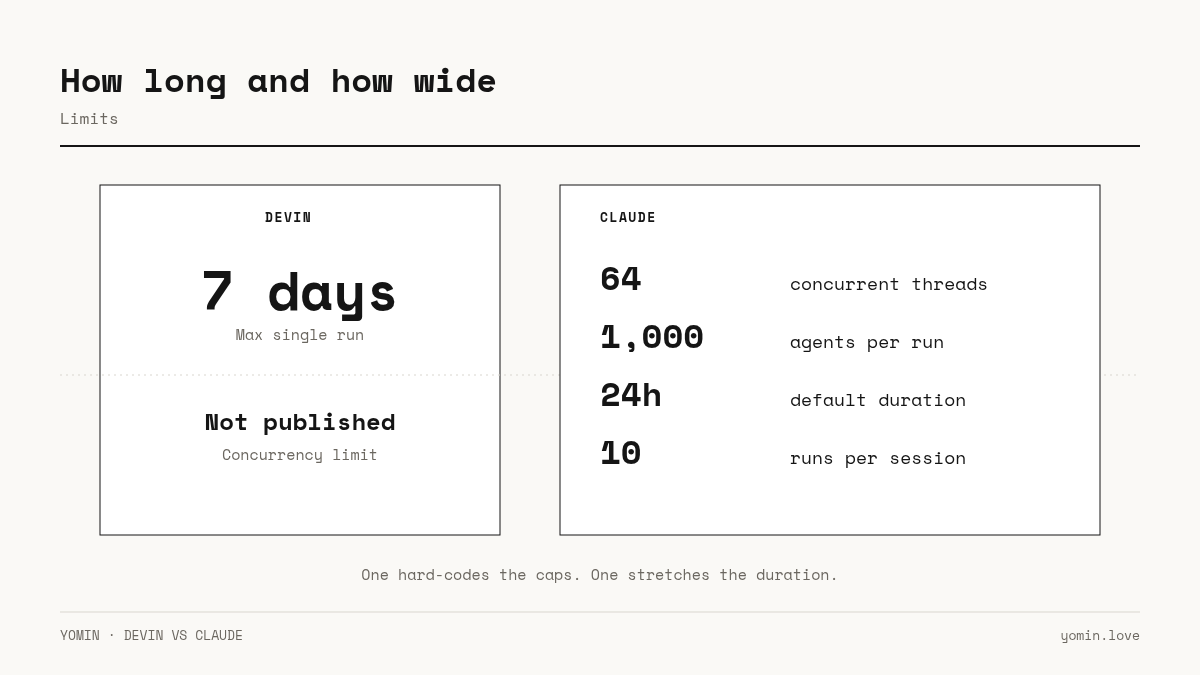
- 限制。Managed Agents 文档写明:64 个并发线程,每次运行 1,000 个 agent,默认 24 小时,每个会话 10 次运行。Devin 的单次运行最长可到 7 天。
- 计费。Claude 按每个 agent 用掉的 token 计费。Devin 按 ACU 计费,并允许你把后面的阶段切到更便宜的 Lite 模型。
- 历史。Devin 从工程出发:计划和 playbook。Claude Code 从模型出发:自由委派,一轮一轮来。现在双方都在向对方靠近。
- 结构化输出。每个 Devin 调用都带一份 JSON Schema,所以 agent 之间的交接可以被检查。
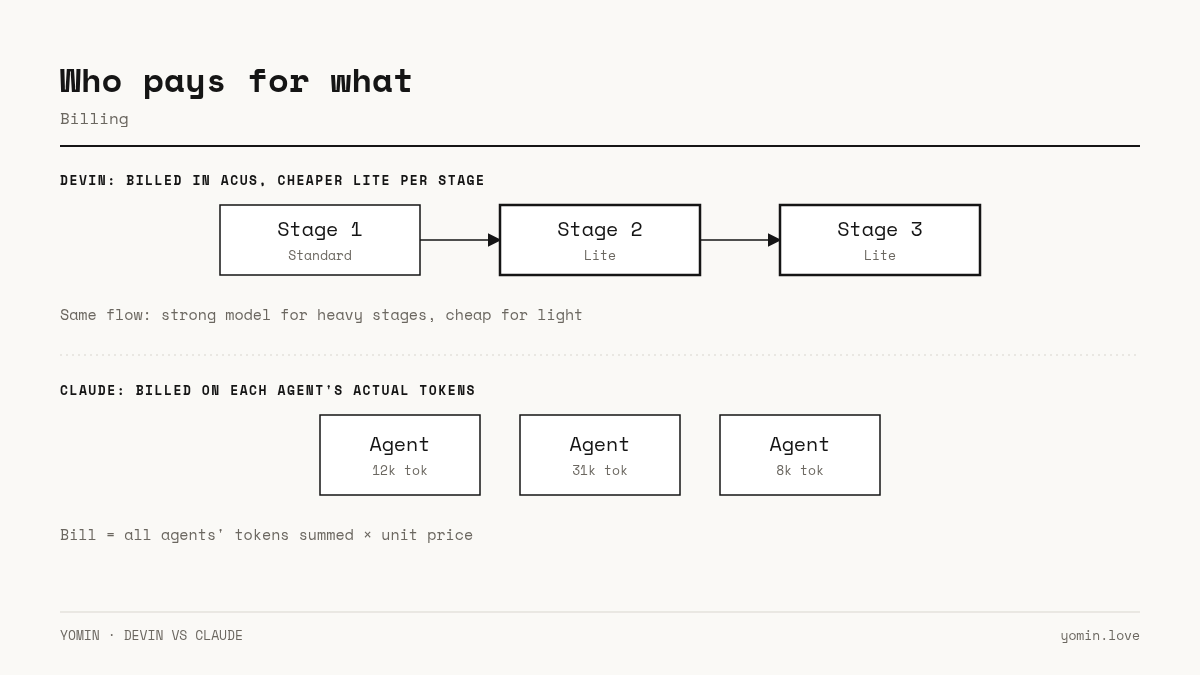
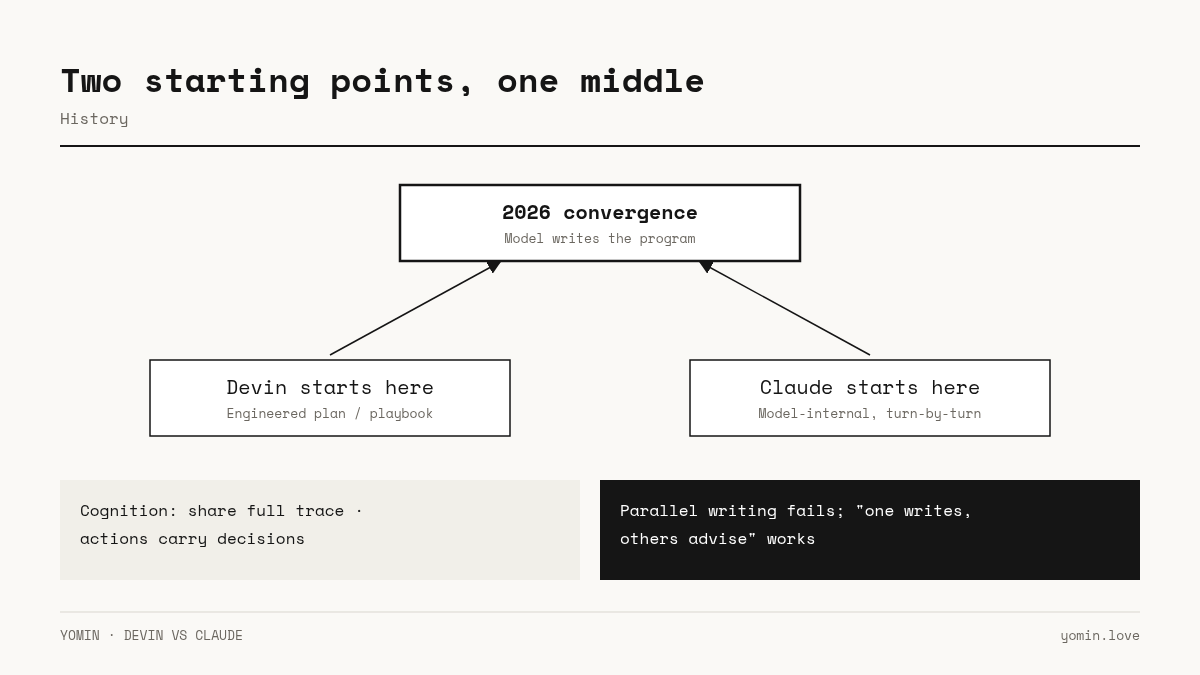
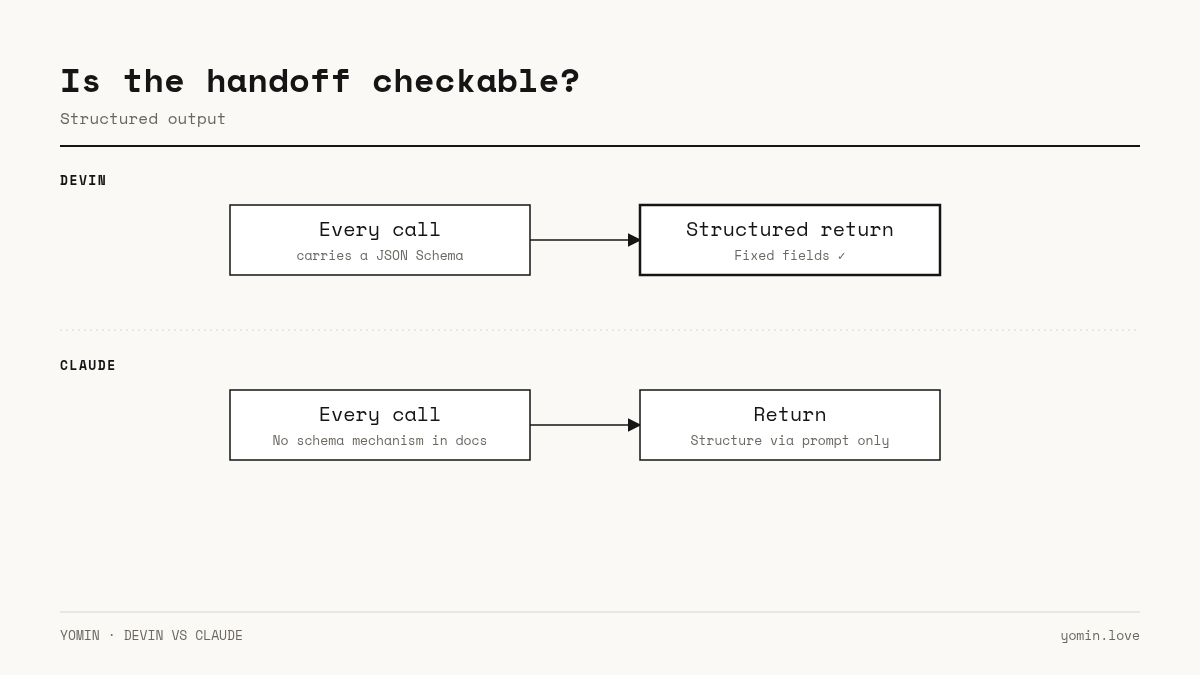
如果只能用一句话概括:Devin 倾向于一份可以复现的产物,Claude 倾向于一个保持灵活的运行时。两边都没错,它们防的是不同类型的失败。
Claude 里有三样东西都叫“multi-agent”
这一点容易绕晕人,我先把它们分开。
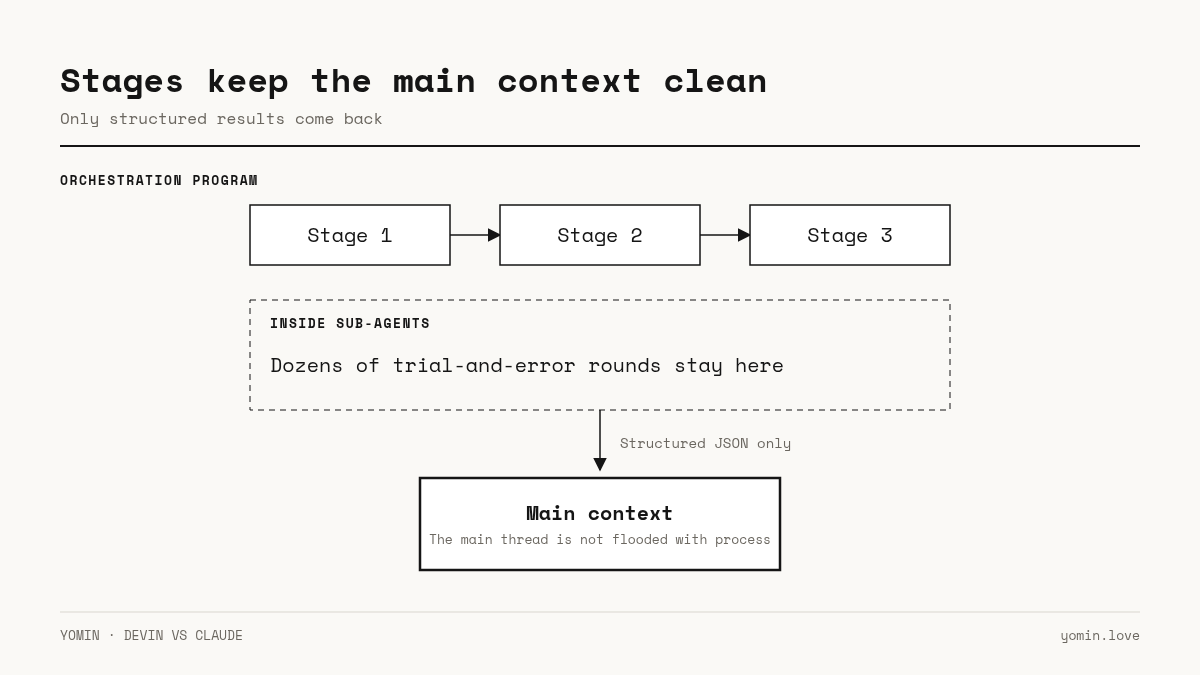
- 经典 sub-agent。在一个会话内运行。每个都有自己的上下文窗口,只把总结传回来。
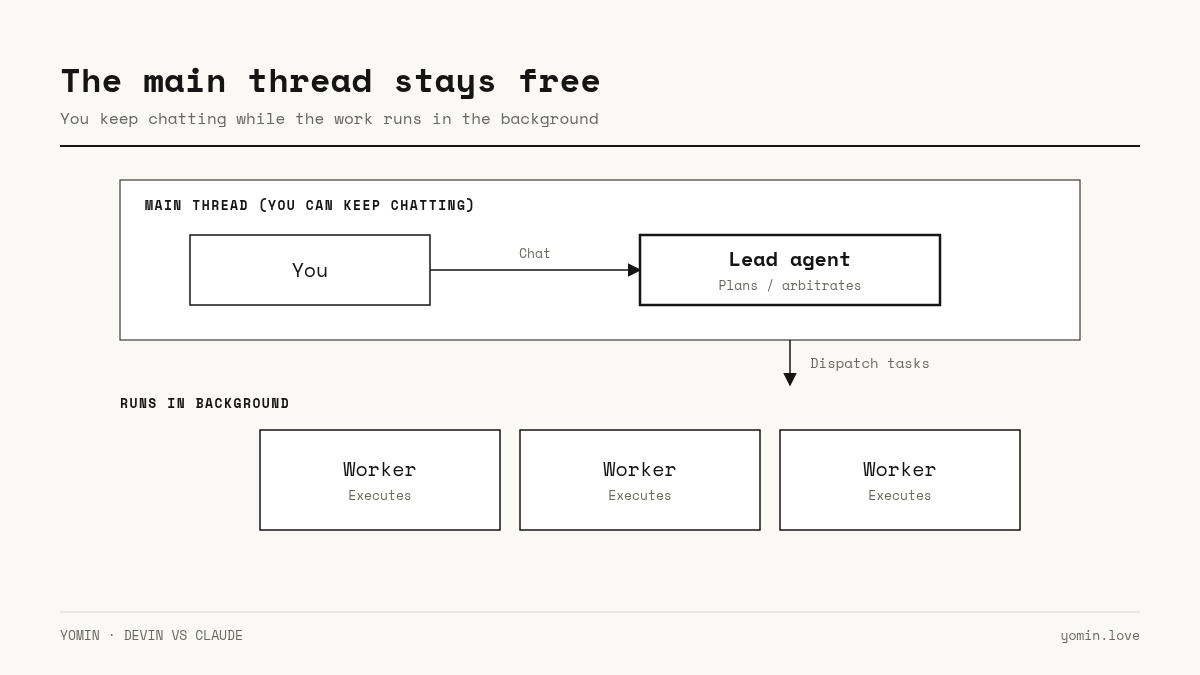
- Managed Agents。托管在服务器上,由模型来写程序。公告里说的就是这个。
- Claude Code 本地 workflows。用 JavaScript 写,默认并发数 16。
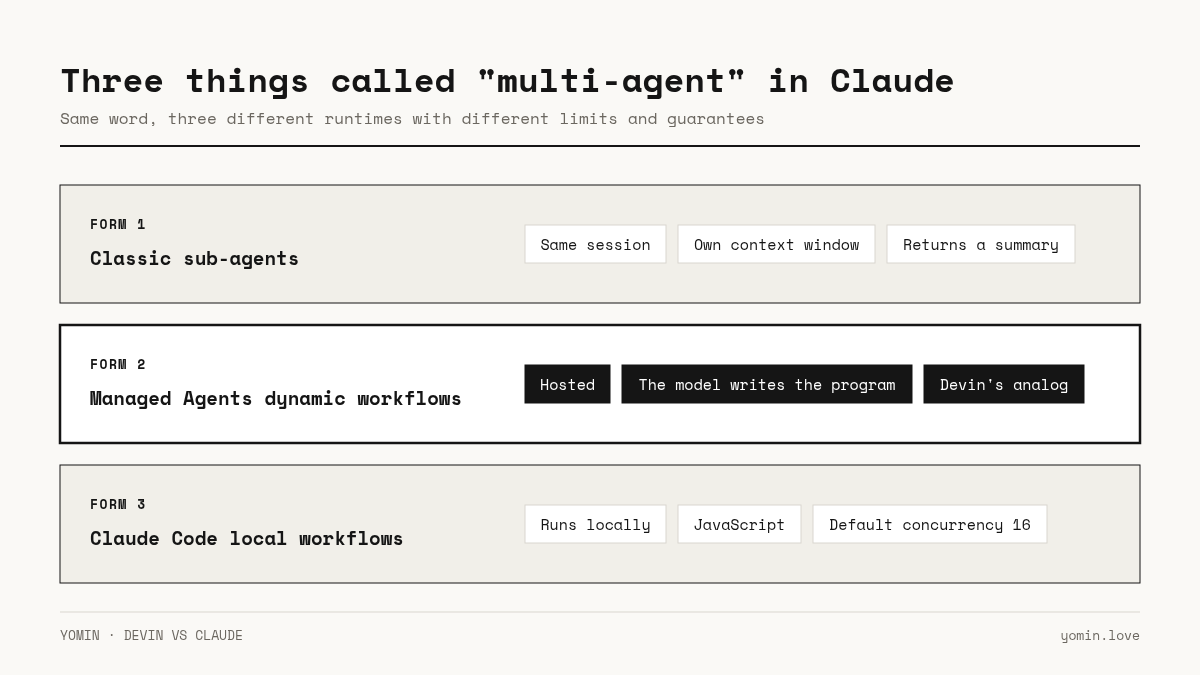
同一个词,三种不同的运行时,各有各的限制和保证。如果你要拿“Claude multi-agent”和 Devin 比,先决定你说的是这三个里的哪一个。
两边在靠拢
Devin 从结构出发,正在加入模型的判断。Claude 从模型的判断出发,正在加入结构。
Devin 从 2026 年 3 月起就在往这个方向走,那时它学会了管理一队 Devin。Claude 的 Managed Agents 有写出来的程序、预算和运行上限,也是朝同一个中间点迈出的一步。
Cognition 自己的文章《Don't Build Multi-Agents》是个很好的参照。它有两条原则:共享完整的 trace;每个动作都带着隐含的决定。彼此看不到对方选择的并行 agent,最后会做出互相冲突的选择。在 2026 年 4 月的更新里,Cognition 说并行写代码行不通,而“一个写,其他只给建议”可行。他们的 review agent 平均每个 PR 能抓出 2 个 bug,其中 58% 是严重的。这个数字是 Cognition 自己的,当作厂商的说法来看。
Anthropic 工程博客在谈它的 multi-agent 研究系统时说了一句听上去相反、其实并不矛盾的话。在研究任务上,multi-agent 比单 agent 好 90.2%,token 用量解释了 80% 的性能差异。token 大约是普通聊天的 15 倍。Anthropic 说这适合并行、信息量大的工作,不适合 agent 之间需要共享上下文的情况。
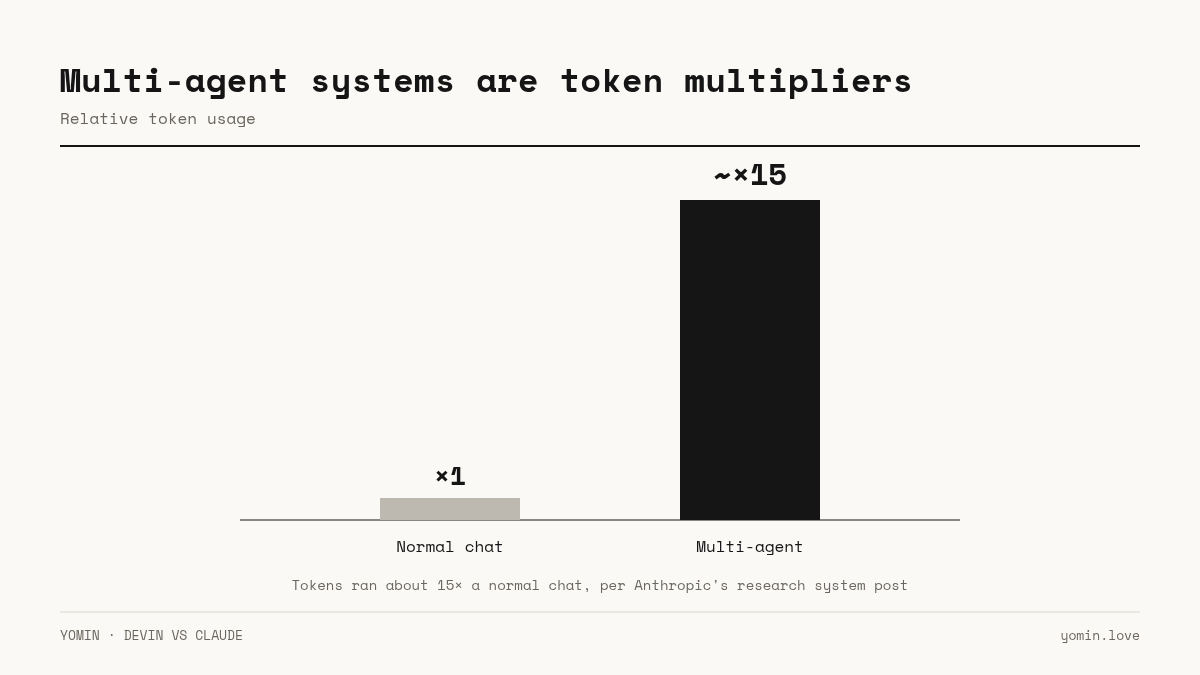
放在一起看,两篇文章说的是同一件事。当工作能干净地拆开、而且大部分是在读的时候,并行是划算的。当很多 agent 要往同一个东西里写的时候,它就垮了。
说一句营销。像 70 个 bug 的测试这样的说法,来自三次内部运行。我会把它当作厂商的说法,而不是 benchmark。
为什么模型和设计一样重要
Multi-agent 系统会成倍地消耗 token。划不划算,取决于一个 token 多少钱。
Opus 5.5 在 9 月 22 日发布。它比 Opus 5 便宜 40%,缓存读取便宜 60%。Anthropic 更新的 prompting 指南里还加了针对 agent 的建议,包括 effort 分档:主 agent 用 high,子 agent 用 low。
在我看来,这才是这些公告底下真正的故事。编排之所以变得可行,是因为模型变便宜了,也因为厂商开始告诉你怎么在多个 agent 之间分配 effort。只有当运行很多 agent 负担得起时,让模型写程序才行得通。
作为做产品的人,我从中拿到什么
我不觉得问题是“Devin 还是 Claude”。问题是:哪些交给模型即兴发挥,哪些用代码固定下来,这条线划在哪。
我会从这里开始。
让模型即兴决定形状:怎么拆任务,要几个 worker,每个去找什么。这每个任务都不一样,写死会很脆。
凡是之后你要信任的东西,都用代码固定:交接上的 schema、谁拥有写权限、重试和恢复的行为、预算、超时。如果某个失败可能让你调试一整晚,它就该放在代码里,而不是 prompt 里。
在扇出之前做三项检查:
- 工作能不能拆成只有一个 agent 在写?如果不能,预期会有冲突。
- 你能看到计划吗?如果脚本是隐藏的,想办法把它取回来。
- 如果中途挂了,什么会重跑?“全部”是一个真实的答案,而且有代价。
两家厂商都在向中间靠拢,这说明这不是口味问题。纯即兴很难信任,纯脚本又太死板。真正的工作,是为你自己的产品选定这条边界,而且我预计随着模型越来越便宜,这条边界会继续移动。
接下来我会看两边各自如何处理重放和可见性。那是它们差别最大的地方,也是我预期两边都会变的地方。